Über mich
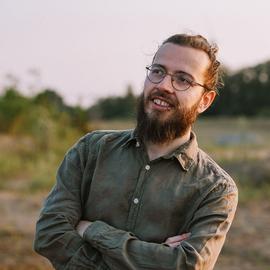
Hallo! Mein Name ist Sven Lieber, willkommen auf meiner Webseite. Momentan bin ich Data Manager in der Abteilung für Forschung und Innovation an der Königlichen Bibliothek Belgiens (KBR). Wir sammeln und archivieren (Daten über) alle Belgischen Publikationen. Ich trage dazu bei, unsere Daten über das belgische Kulturerbe Forschern und der Öffentlichkeit zugänglich zu machen, indem ich die Datenqualität erhöhe und die Datenverarbeitungsabläufe verbessere. Hauptsächlich arbeite Ich an den Projekten MetaBelgica und BELTRANS.
Ich bin ein neugieriger Mensch und sehe mich selbst als Knowledge Scientist. Jemand der sich in ein Gebiet oder Problem einarbeitet, Daten analysiert und im darauffolgenden Schritt Lösungen ausarbeitet und anwendet. Das schließt auch die Kommunikation der Resultate in angemessener Form mit ein.
Auf dieser Webseite teile ich Blogposts und digitale Ressourcen zu meinen öffentlichen Publikationen und Präsentationen.
- Semantic Web
- Cultural Heritage
- FAIR data
- Digital Humanities
- Provenance
- Web Annotations
-
PhD in Information Engineering Technology, 2022
Universiteit Gent, Belgien
-
MSc in Informatik, 2016
Albert-Ludwigs Universität Freiburg, Deutschland
-
BSc in Kommunikations- und Softwaretechnik, 2013
Hochschule Albstadt-Sigmaringen, Deutschland
Recent Posts
In a world with generative AI, semantically annotated data of high quality is also of high value! The SEMANTiCS conference usually brings together not only Semantic Web scholars, but also players from the industry. More than 400 people attended the 22nd edition of SEMANTiCS in Ghent, Belgium from September 15 to 17, 2026. Apparently a record number of participants! In this blog post I will reflect on some of the keynotes and talks that I have attended. As always with references, links, and archived at the Rogue Scholar.


Recent & Upcoming Talks
Recent Publications
FAQ
Frequently Asked Questions
Enthalten deine Blogbeiträge Metadaten?
Ja! Neben den Standard-Metadaten-Eigenschaften gibt es einen JSON-LD-Frame, der mit jedem Blogbeitrag ausgeliefert wird. Er enthält Standard-Metadaten, die von Hugo gemäß Schema.org konfiguriert wurden. Basierend auf einigen Erweiterungen, die ich vorgenommen habe, gibt es auch Schema.org-Annotationen, die den Inhalt mit anderen Linked-Open-Data-Quellen wie Wikidata verknüpfen.
Ist der Newsletter noch aktiv?
Kurz gesagt: nein. Ich habe den Newsletter 2023 gestartet und fast ein halbes Jahr lang regelmäßig wöchentlich/zweiwöchentlich neue Beiträge veröffentlicht. Aber seit der Geburt meiner Tochter hat sich meine Work-Life-Balance verändert, sodass es vorerst keine weiteren Newsletter-Ausgaben mehr gibt.
Wie ist dieser Blog aufgebaut?
Ich verwende die Open-Source-Software Hugo und ihr akademisches Theme (wowchemy alias Hugo Blox), um statische HTML-Dateien zu erstellen. Der Quellcode meiner Website ist auf GitHub verfügbar: https://github.com/SvenLieber/website
Wie kann ich einen Blogbeitrag zitieren?
Alle meine Blogbeiträge werden über The Rogue Scholar archiviert und erhalten eine DOI. Die DOI-badge steht am Anfang jedes Beitrags oder nach der Zusammenfassung auf den Übersichtsseiten.
Was ist das blaue DOI-Badge am Anfang eines Blogbeitrags?
Dies ist der persistente Document Object Identifier (DOI) des Blogbeitrags. Alle meine Blogbeiträge werden über The Rogue Scholar archiviert und erhalten eine DOI-Kennung. Selbst wenn mein Blog irgendwann einmal nicht mehr existieren sollte, bleibt der DOI-Link funktionsfähig und leitet die Anfrage stattdessen zur archivierten Version des Beitrags weiter. Derzeit verweisen die DOI-Links eines Beitrags auf den Beitrag auf meiner Website.